반응형
블로그 이미지
개발자로서 현장에서 일하면서 새로 접하는 기술들이나 알게된 정보 등을 정리하기 위한 블로그입니다. 운 좋게 미국에서 큰 회사들의 프로젝트에서 컬설턴트로 일하고 있어서 새로운 기술들을 접할 기회가 많이 있습니다. 미국의 IT 프로젝트에서 사용되는 툴들에 대해 많은 분들과 정보를 공유하고 싶습니다.
솔웅

최근에 올라온 글

최근에 달린 댓글

최근에 받은 트랙백

글 보관함

카테고리


반응형

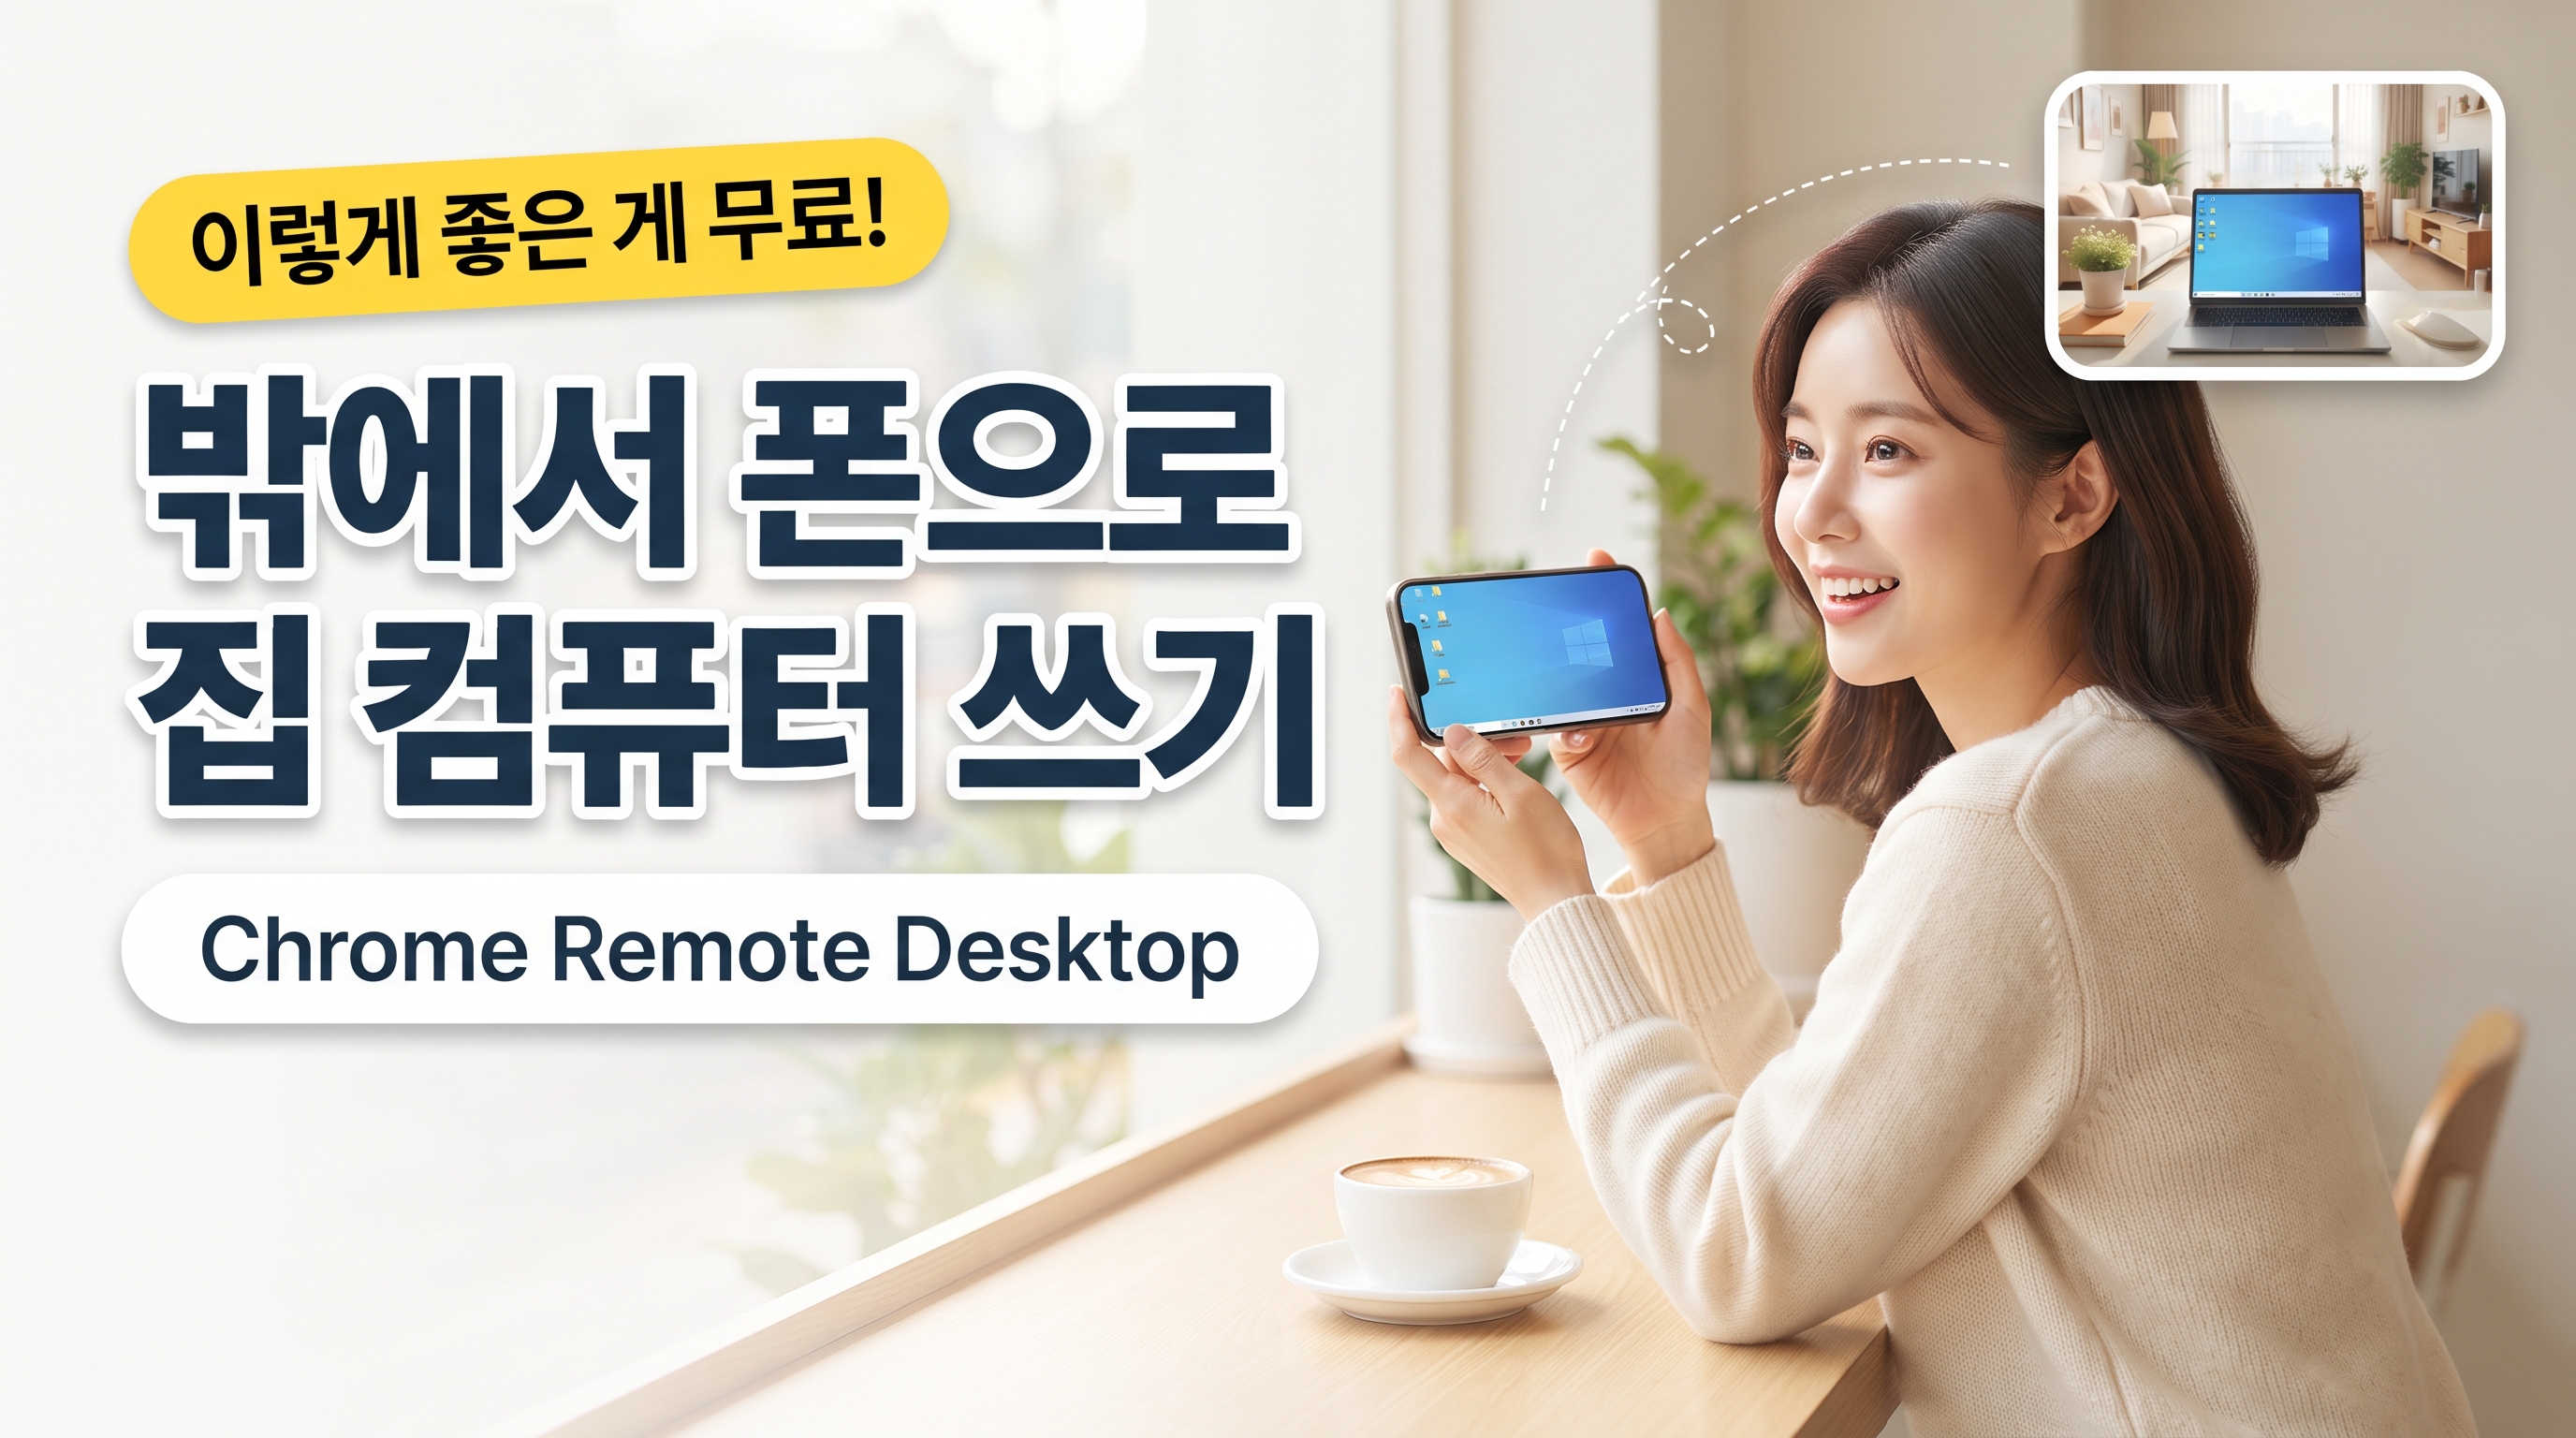
밖에서 집 컴퓨터를 써야 할 일이 생각보다 자주 생깁니다. 두고 온 문서를 확인해야 할 때도 있고, 저처럼 집 컴퓨터에 Claude Code · Codex 같은 AI 도구를 일 시켜 두고 나온 경우에는 "지금 잘 돌고 있나?"가 계속 궁금합니다. 이번에 구글의 무료 도구 크롬 원격 데스크톱(Chrome Remote Desktop, 이하 CRD)을 2주 동안 직접 설치하고, 집 안 · 카페 · 모바일 데이터에서 써 보고, 원격 재시작까지 실측한 내용을 15분 영상과 GitHub 문서로 정리했습니다.

https://youtu.be/Uj47SPD6owc


CRD 는 무엇이고, 무엇이 필요한가

원리는 TV 리모컨과 같습니다. 실제 작업은 집 컴퓨터가 하고, 폰 · 태블릿은 그 화면을 받아 보면서 조작만 보냅니다. 그래서 집 컴퓨터가 켜져 있고 인터넷에 연결돼 있어야 합니다. 공유기 포트 포워딩 같은 설정은 필요 없습니다 — 연결은 구글 계정을 통해 중계됩니다.

준비물은 네 가지입니다: Windows 컴퓨터, 그 컴퓨터의 Chrome, Google 계정 하나, 밖에서 쓸 기기. 이번 실측은 Windows 11 노트북(호스트) + iPad 사파리(클라이언트)로 했습니다. iOS 앱은 2025년 9월에 종료돼서 iPad · iPhone 은 웹으로 접속합니다.

설치에서 가장 많이 헷갈리는 세 곳

  • 설치가 두 번이다. 「Chrome 에 추가」(브라우저 확장) 다음에 「컴퓨터용 프로그램」(밖에서 오는 연결을 받는 호스트 서비스)을 또 설치합니다. 첫 번째에서 멈추면 목록에 컴퓨터가 안 뜹니다.
  • 절전 ≠ 화면 끄기. 화면이 꺼지는 건 괜찮지만, 절전에 들어가면 밖에서 연결이 안 됩니다. 저는 전원 연결 시 「화면 10분 · 절전 안 함」으로 뒀습니다.
  • 비밀번호가 두 개다. CRD 에 들어갈 때의 PIN(6자리 이상)과 Windows 잠금 화면의 로그인 비밀번호는 다릅니다. 이 두 겹이 컴퓨터를 지킵니다.

보안: 「연결 끊기」와 「잠그기」는 다르다

원격 세션에서 Disconnect 만 누르면 집 화면은 로그인된 채로 남을 수 있습니다. 그래서 순서는 항상 Windows 잠금 → 잠금 화면 확인 → 연결 끊기입니다. 원격 화면의 시작 메뉴 → 전원 버튼 → Lock(없으면 계정 이름 → 잠금)으로 잠급니다. 그리고 「원격 지원(Remote Support)」은 남을 잠깐 도와줄 때 쓰는 기능이라, 모르는 사람이 이걸로 들어오게 해 달라고 하면 사기를 의심해야 합니다.

실측: 카페에서 5초, 원격 재시작 뒤 1~2분

동네 카페 와이파이에서 연결까지 체감 약 5초였고, 문서 읽기 · 원격 입력 · 잠금 · 연결 끊기 · 재접속까지 내용이 그대로 남았습니다. 원격 재시작은 두 번 해 봤습니다. 원격 화면에서 시작 → 전원 → 다시 시작을 누르면 「session has ended」 알림이 뜨고, 목록에는 계속 Online 으로 보이지만 실제로는 1~2분 기다린 뒤 다시 눌러야 잠금 화면으로 연결됩니다. CRD 호스트가 Windows 와 함께 자동 시작되기 때문입니다. 다만 전원이 꺼졌거나 컴퓨터 쪽 인터넷이 끊긴 경우, Windows 업데이트 설치 중이거나 BitLocker 부팅 전 PIN 을 쓰는 경우는 다를 수 있습니다.

AI 에이전트를 쓰는 사람에게 더 좋은 이유 — 창문과 현관문

Claude Code 의 Remote Control, Codex 의 원격 기능처럼 앱마다 원격 기능이 있습니다. 평소에는 이쪽이 편합니다. 하지만 이건 창문입니다 — 그 앱 안만 보이고, 앱 자체가 멈추면 그 원격 기능도 함께 멈춥니다. CRD 는 현관문입니다. 컴퓨터 전체로 들어가니 멈춘 작업 창을 닫고 AI 도구를 다시 켜거나, 필요하면 Windows 를 재시작할 수 있습니다. 그래서 둘 중 하나를 고르는 게 아니라 평소엔 앱 원격, 문제가 생기면 CRD 로 복구하는 조합을 권합니다. (Grok Bot · Meta Muse · OpenAI dots 처럼 회사 클라우드 컴퓨터에서 일하는 에이전트는 성격이 달라 다음에 따로 다룹니다.)

문서와 영상


Chrome 원격 데스크톱으로 다른 컴퓨터에 액세스하기 - 컴퓨터 - Google Chrome 고객센터

도움이 되었나요? 어떻게 하면 개선할 수 있을까요? 예아니요

support.google.com


CatchUpAI_VL/Topics/Chrome-Remote-Desktop at main · solkit70/CatchUpAI_VL

Catch Up AI Vibe Learning - AI와 함께하는 체계적인 학습 방법론. Contribute to solkit70/CatchUpAI_VL development by creating an account on GitHub.

github.com


이 정리는 VibeLearn AI 방식으로 2주 동안 진행한 학습 Topic 의 결과물입니다. 대안 도구(RustDesk 등) 비교와 「CRD 가 안 될 때」 점검표도 GitHub 문서에 있습니다.


반응형


반응형

검색 AI가 좋은 답을 내놓는지 확인할 때, 답변의 정확도만 비교하면 충분할까요? 검색 서비스를 바꿨을 때 실제 사용자의 경험과 목표 달성에 어떤 차이가 생기는지도 살펴야 합니다.

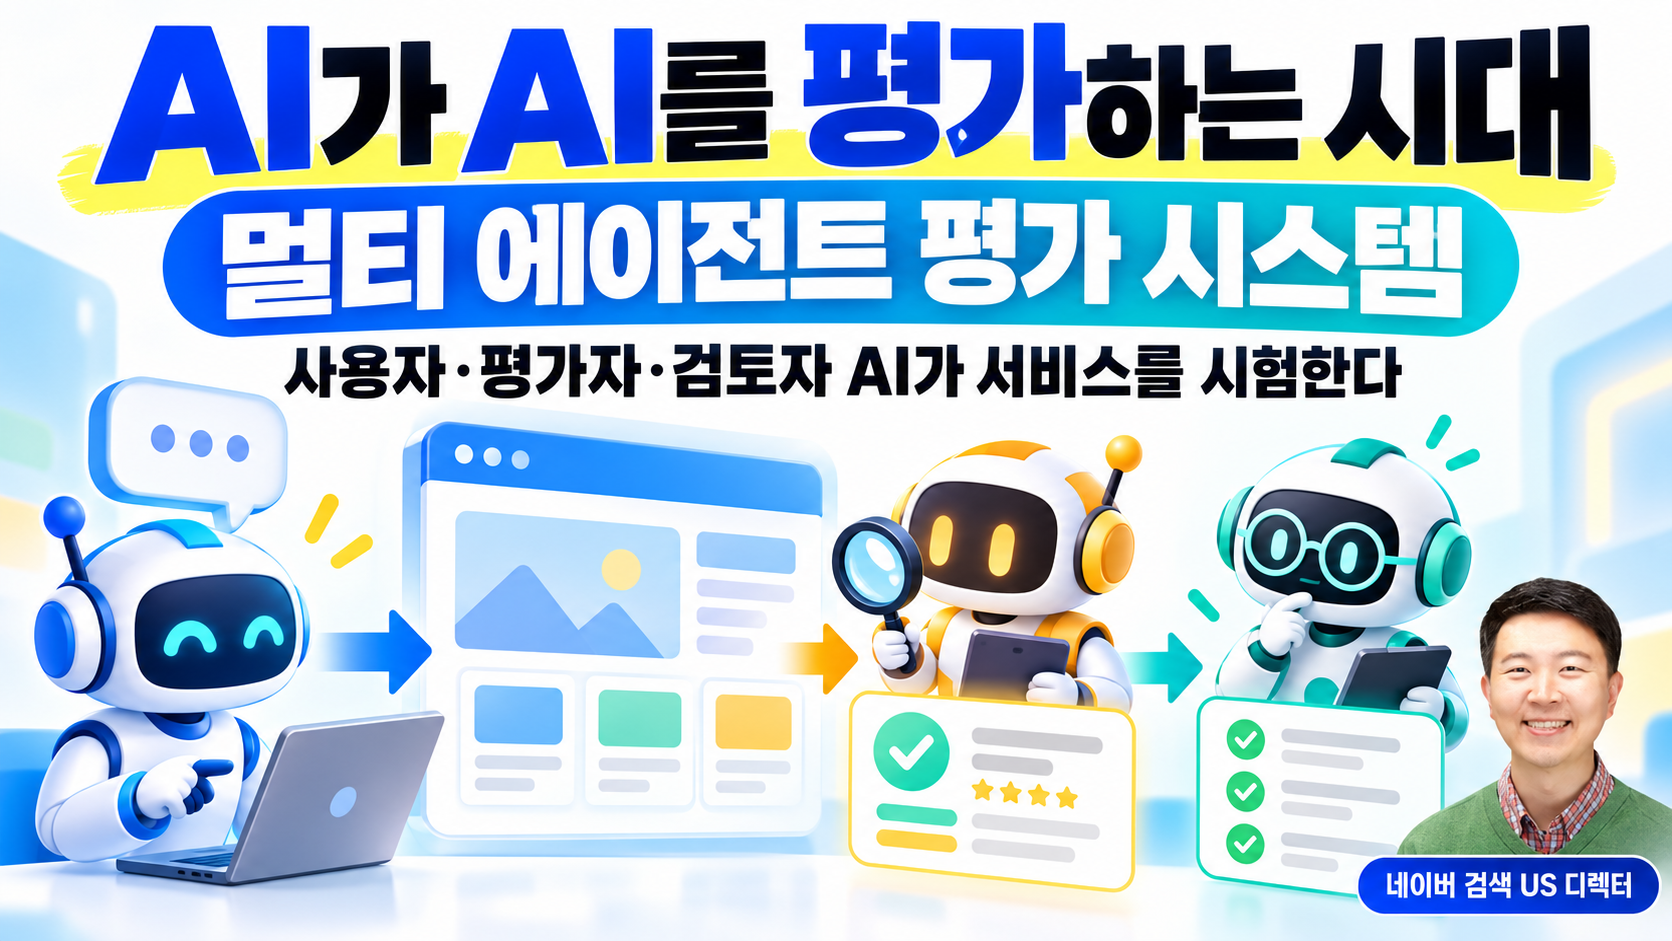
Builders Lounge 5차 모임에서 김진영 네이버 검색 US 디렉터님은 이 문제를 다루기 위해 설계·구현한 멀티 에이전트 평가 시스템을 소개했습니다. 시스템은 검색을 실제 사용자처럼 수행하는 User Agent, 그 결과와 경험을 평가하는 Evaluator, 평가가 일관된 기준으로 이루어졌는지 살피는 Auditor로 구성됩니다.

사용자처럼 검색하는 에이전트

User Agent는 정해진 검색 태스크를 받아 검색 서비스를 이용합니다. 답변을 읽고 사용자의 목표가 달성됐는지, 어떤 경험을 했는지 평가할 수 있도록 대화와 행동 과정을 남깁니다. 검색 시스템마다 같은 태스크를 수행하게 해 결과를 비교하는 출발점입니다.

평가자와 검토자의 역할

Evaluator는 태스크에 적힌 성공 기준 (Success Criteria)을 바탕으로 답변과 검색 경험을 평가합니다. Auditor는 비교 대상별 평가가 같은 기준으로 진행됐는지 살핍니다. 평가 기준을 만들 때는 기대 답을 고정된 Ground Truth로 간주해도 되는지, 검색 지식이 질의와 시점에 따라 바뀌는 문제를 어떻게 다룰지 고민이 필요합니다.

발표에서 소개한 평가 결과가 외부 벤치마크나 NPS와 검증 완료됐다는 뜻은 아닙니다. 김진영님은 내부에서 사용하는 지표와 결과가 일치하는지 확인하려 한다고 설명했습니다.

실제 사용자 실험 전의 가상 사용자 평가

발표에서는 대표성 있는 여러 사용자 페르소나를 에이전트로 구성해 실제 사용자 대상 A/B 테스트 전에 서비스를 탐색해 보는 가능성도 다뤘습니다. 이 방식은 실제 사용자를 완전히 대체하는 것으로 소개된 것이 아닙니다. 페르소나를 어떻게 객관적으로 정의할지, 공개 자료와 서비스에서 얻은 실제 사용자 데이터를 어떻게 활용할지가 중요한 과제로 남습니다.

AI 개발에서 사람의 역할

질의응답과 토론에서는 프로토타입을 만드는 것과 다른 사람도 사용할 수 있는 제품으로 다듬는 일의 차이도 이야기했습니다. 큰 목표를 작은 하위 작업으로 나누고, 무엇을 만들지 정하고, 결과를 검토하는 사람의 역할은 여전히 필요하다는 경험을 나눴습니다.

AI 요약을 읽고 끝내면 여러 출처를 직접 비교하며 쌓던 맥락과 판단력이 줄어들 수 있다는 우려도 나왔습니다. 검색과 AI 요약에는 각기 다른 장단점이 있으며, AI가 만든 결과를 확인하고 이해하는 과정도 중요하다는 논의였습니다.

영상과 발표 자료

영상은 한국어 발표이며 영어 자막을 제공합니다. YouTube 자막(CC)에서 영어를 선택할 수 있습니다.

https://youtu.be/FdWigceb1pk


반응형


반응형

샌프란시스코에서 공무원으로 일하는 회원분이 Builders Lounge 5차 모임에서 발표한 내용을 정리한다. 시스템을 모니터링하다 서버에 장애가 생기면 AI 에이전트들이 원인을 분석하고 조치를 제안하는 Multi-Agent 시스템을 만든 과정이다.

https://youtu.be/nypuwYuyMJQ


시작은 새벽 3시였다

장애가 나서 팀 전체가 깨어났는데 원인은 로그인 서버의 사소한 이슈였다. "이 정도는 AI가 알아서 하면 되지 않나?" 여기서 프로젝트가 시작됐다.

왜 단일 LLM이 아니라 Multi-Agent인가

단일 LLM으로 가면 상황을 전부 모아 한 번에 보내야 해서 컨텍스트가 터진다. 툴도 한 에이전트가 전부 들고 있어야 한다. 역할을 쪼개면 각 에이전트가 훨씬 적은 컨텍스트를 보내고, 자기에게 필요한 툴만 쓴다.

구조는 이렇다.

  • Brain — 오케스트레이터. 시스템 전반을 본다
  • Judge — 진짜 문제인지 판단하고 심각도(info/warning/critical)를 정하며 알림 발송 여부를 결정한다
  • Investigation — 조사한다. 병원으로 치면 인턴·레지던트
  • Specialist — 전문의. 조사 결과를 다시 보고 진단한다
  • Airman — 사용자 인터페이스
  • Agent Bus — 에이전트 간 통신 채널

ReAct 루프 — 증거를 쌓아 Confidence를 올린다

Thought → Action → Observation → Loop 를 돈다.

메모리가 95%다 → 어떤 프로세스가 원인일까 → 툴을 골라 실행 → Java가 8.2GB를 먹고 있다 → 여기서 끝이 아니라 다시 묻는다 → 최근 배포가 있었나 → GitHub 툴 → 2시간 전에 누가 바꿨다. 증거가 둘이 됐다. Confidence가 0에서 0.92까지 올라가면 조사를 완료하고 최종 가설을 낸다.

툴은 하드코딩하지 않는다 — 동적 디스커버리

사용 가능한 에이전트를 등록해 두고, LLM에게 capabilities를 넘겨 AI가 직접 어떤 툴을 쓸지 고르게 한다. switch문 하드코딩이 사라지므로 에이전트를 추가해도 Judge 코드를 고칠 필요가 없다.

하루에 토큰 100만 개를 태웠다

시뮬레이션으로 같은 장애를 반복시키자 에이전트들이 매번 LLM을 때렸다. 이미 조사 중인 인시던트인데도. 회사 토큰이 바닥나고 개인 토큰까지 날아갔다.

해결은 두 겹이다.

  1. 시그니처 기반 중복 제거 — 네임스페이스·문제 유형·발생 시각으로 같은 인시던트인지 판별하고, 조사 중이면 스킵한다. 이것만으로 토큰 사용량이 20배 이상 감소했다
  2. AI Gateway — AI 모델을 게이트웨이로 감싸 모든 에이전트가 이 관문을 통과해야만 LLM을 쓸 수 있게 했다. Rate Limit, CoolDown, Kill Switch가 여기 붙는다

Stateful / Stateless 분리 — 200개를 107개로

타겟이 100개면 에이전트도 100개. 각 타겟마다 고유한 모니터링을 하려면 그래야 할 것 같지만, 그렇게 하니 응답이 느려졌다. 에이전트들이 AI를 너무 많이 썼다.

AI와 대화하며 나온 답은 에이전트에도 종류가 있다는 것이었다.


OLD: 100개 서버/NS → 200개 LLM Agent 객체
NEW: 100 TargetAgents (가벼운 상태 객체)

  • 7 LLM Workers (공유 compute)
    = 107개 객체

핵심 원칙은 이 한 줄이다. "LLM을 application object에서 compute resource로 격하시킨다." 타겟이 1,000개로 늘어도 Pool은 안 늘어난다.

Harness Engineering

프롬프트 엔지니어링이 "무엇을 해라"였다면, 지금은 너무 강력해져서 "무엇을 할 수 있는지"를 제한해야 한다는 이야기다. 말을 그냥 풀어놓을 수 없으니 안장을 얹고 굴레를 채우듯이.

적용한 장치들 — State Machine(허용된 전이만), Timeout, Rate Limit, CoolDown, Kill Switch(이머전시 스톱), State History(모든 AI 호출 기록).

객체화 — "지금 에이전트가 몇 개 돌고 있나요?"

이 질문에 답하기가 의외로 어렵다. 에이전트를 객체로 만들고 Parent(서버/네임스페이스) 아래에 두면 정확한 개수를 셀 수 있고, 특정 서버의 에이전트만 골라서 끌 수 있다. 서버를 스케일 업할 때 에이전트 수가 어떻게 늘어나는지 보이므로 스케일 판단 근거도 된다.

왜 Python이 아니라 Go인가

에이전트가 100개, 1,000개, 10,000개로 가면 Python으로는 안 된다. 프로세스를 나누려면 Redis 같은 것이 필요해진다. Go는 Go 스케줄러가 OS 스레드를 계속 관리하면서 goroutine으로 수백 개를 Redis 없이 동시에 돌린다.

시행착오가 업계 표준으로 수렴했다

겪은 문제 나온 해법

중복 호출로 비용 폭발 AI Gateway
무한 반복 TimeoutWatcher
상태가 꼬임 State Machine
에이전트 간 책임 불분명 역할별 에이전트 분리
장애 시 복구 어려움 State History 기반 복구
위험한 행동 Human In The Loop
에이전트 추적 불가 객체화

그렇게 하나씩 고쳐 놓고 보니 Anthropic이 권하는 Agentic 아키텍처와 거의 같았다.

"결국 업계에서 말하는 것도 과학자가 딱 설계해서 나온 게 아니라, 다들 비슷하게 시행착오를 거치면서 필요한 걸 다 적용하다 보니 그렇게 되더라."

기술 스택

Go · WebSocket(백엔드가 UI로 푸시) · SSH · Kubernetes · Qdrant(벡터 DB) · Next.js · Zustand · Tailwind CSS. 모델은 ChatGPT Mini로 충분했다 — 고도의 추론이 아니라 오퍼레이션 추론이기 때문이다.

"구글 검색을 안 쓴 지 2년 됐습니다"

기술 선택을 어떻게 했냐는 질문에 나온 답이다. AI에게 물어보되 "검색을 하고 알려달라" 고 요구한다. 학습 시점이 과거여도 그렇게 물으면 현재 시점으로 검색해서 답한다. 그리고 KIRO·Claude·ChatGPT를 오가며 교차 검증한다.

Q&A — 이걸 Red Teaming에 쓰면?

발표 뒤 토론이 발표만큼 재미있었다. 같은 시스템을 공격 쪽으로 돌릴 수 있는가에서 시작해, 스트레스 테스트로 일부러 망가뜨리고 블루팀 에이전트가 잡아내는지 보는 방식, Chaos Monkey, 그리고 "AI를 막으려면 결국 AI를 써야 한다"는 전망까지 갔다.

마지막으로

"2026년 현재 AI들은 이런 아키텍처까지 결정할 정도로 똑똑하지는 않다. 사용자 수준에 맞춰 주는 것 같다. 사람이 계속 조율해야지 AI에게 모든 것을 맡겨 놓으면 절대 안 된다."


이 발표는 Builders Lounge 5차 모임에서 있었다. AI로 뭔가를 만드는 사람들이 서로의 작업을 소개하고 직접 써 보며 피드백을 주고받는 모임이다.


Builders Lounge


www.youtube.com


Builders Lounge 입장 안내

Builders Lounge 입장 안내

claude.ai


builders-lounge-personal-notes/assets/presentations at main · solkit70/builders-lounge-personal-notes

Changsoo's personal notes and records for Builders Lounge meetings, discussions, ideas, and AI-assisted community building. - solkit70/builders-lounge-personal-notes

github.com


반응형